Einleitung
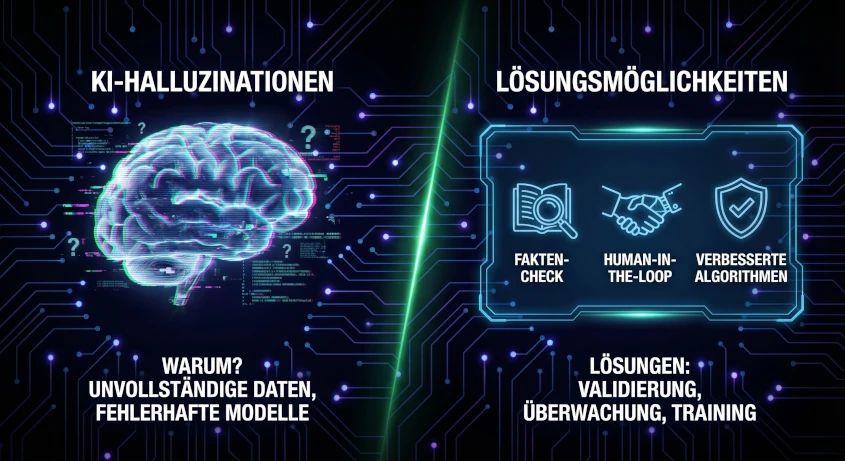
Künstliche Intelligenz (KI) hat in den letzten Jahren signifikante Fortschritte gemacht, aber sogenannte KI-Halluzinationen – fehlerhafte oder irreführende Antworten – bleiben eine Herausforderung. Diese können in kritischen Bereichen wie dem Gesundheitswesen oder der Rechtsprechung zu erheblichen Problemen führen. Ursachen solcher Halluzinationen sind die probabilistische Wortvorhersage, Einschränkungen der Trainingsdaten und die Modellarchitektur. Lösungsansätze umfassen die Retrieval-Augmented Generation (RAG), verbesserte Trainingstechniken wie Reinforcement Learning from Human Feedback (RLHF) und die Entwicklung spezifischer Benchmarks zur Evaluierung. Durch die Integration menschlicher Aufsicht und spezifische Validierungsprozesse können die Risiken von Halluzinationen weiter minimiert werden.
Ursachen von Halluzinationen in KI-Systemen
Probabilistische Wortvorhersage
Große Sprachmodelle (Large Language Models, LLMs) generieren Text durch die Vorhersage des nächsten Wortes basierend auf statistischen Wahrscheinlichkeiten. Während dies flüssige Texte ermöglicht, können Fehlinterpretationen entstehen, wenn die Modelle auf falsche oder irrelevante Daten zurückgreifen.
Einschränkungen der Trainingsdaten
Die Qualität der Trainingsdaten ist entscheidend. Unvollständige oder voreingenommene Daten können zu fehlerhaften Ergebnissen führen. Regelmäßige Aktualisierungen der Daten sind erforderlich, um die Genauigkeit der Modelle zu gewährleisten.
Modellarchitektur und Trainingsziele
Die Architektur eines Modells und die Ziele des Pre-Trainings beeinflussen die Genauigkeit der Antworten. Modelle sind oft darauf ausgelegt, flüssige Texte zu erzeugen, ohne die Korrektheit der Information sicherzustellen.
Generierungs- und Dekodierungsstrategien
Strategien wie Beam Search oder Temperature Sampling können die Kreativität der Antworten steigern, jedoch auch die Wahrscheinlichkeit von Halluzinationen erhöhen, da sie mehr auf Kohärenz als auf Faktentreue abzielen.
Lösungsansätze
Retrieval-Augmented Generation (RAG)
RAG kombiniert KI-Modelle mit externen Datenquellen, um präzisere Antworten zu generieren. Ein Beispiel ist die Implementierung in Suchmaschinen, die dadurch relevantere Ergebnisse liefern.
Verbesserte Trainingstechniken
Reinforcement Learning from Human Feedback (RLHF) nutzt menschliches Feedback zur Verbesserung der Antwortqualität. Empirische Studien zeigen, dass diese Methode die Genauigkeit von Modellen signifikant erhöht.
Evaluierung und Benchmarking
Die Entwicklung spezifischer Benchmarks zur Messung faktischer Genauigkeit und logischer Konsistenz ist entscheidend für die Verbesserung von KI-Modellen.
Chain-of-Thought und Reasoning-Techniken
Diese Techniken simulieren schrittweise Denkprozesse, um logische Fehler zu reduzieren und nachvollziehbare Entscheidungswege zu schaffen.
Human-in-the-Loop und Sicherheitsmaßnahmen
Menschliche Überwachung in kritischen Bereichen stellt sicher, dass fehlerhafte KI-Antworten erkannt und korrigiert werden, bevor sie Schaden anrichten können.
Chancen & Risiken
KI-Systeme bieten die Möglichkeit, die Qualität von Antworten zu verbessern und das Vertrauen in KI-Lösungen zu stärken. Gleichzeitig besteht das Risiko einer übermäßigen Abhängigkeit von KI, was zu Fehlinterpretationen führen kann.
Handlungsempfehlungen / Checkliste für Entscheider
- Implementierung von RAG in bestehenden Systemen.
- Förderung von Schulungen im Bereich KI und Datenmanagement.
- Etablierung von Evaluierungsstandards zur Überprüfung der Modellgenauigkeit.
- Integration von menschlicher Aufsicht in kritischen Anwendungsbereichen.
Ausblick
Zukünftige Entwicklungen in der KI-Forschung werden sich auf die Minimierung von Halluzinationen konzentrieren. Fortschritte in Modellarchitektur, Trainingstechniken und Evaluierungsmethoden könnten weitreichende Auswirkungen haben.